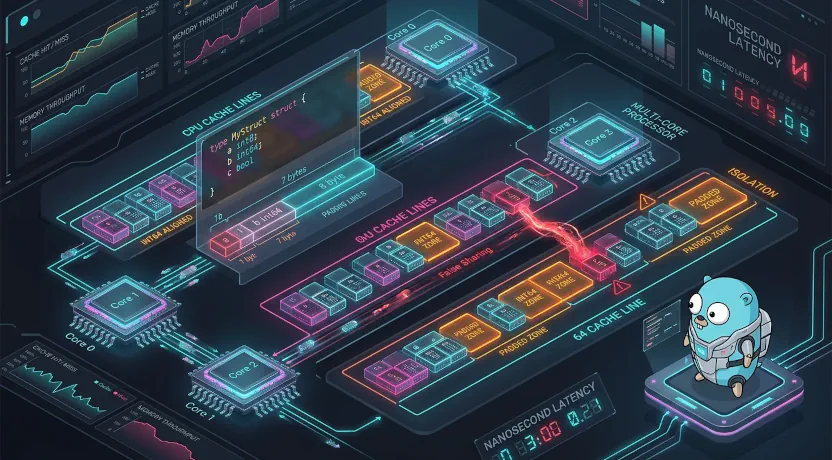
Alignement, Padding et Élimination du False Sharing

L'optimisation des performances en Go ne se limite pas à surveiller l'échappement sur le tas (Escape Analysis), à recycler les objets via sync.Pool ou à favoriser l'inlining. La disposition physique exacte de vos structures de données en mémoire vive (RAM) et dans les lignes de cache processeur conditionne directement la vitesse de traitement de vos programmes.
La gestion du padding mémoire repose sur une dualité fondamentale :
- Le padding involontaire (gaspillage) : causé par un agencement sous-optimal des champs d'une structure, il gonfle l'empreinte RAM, réduit la densité des caches L1/L2 et alourdit le travail du Garbage Collector.
- Le padding intentionnel (accélération) : ajouté délibérément pour atteindre la taille exacte d'une ligne de cache (64 octets), il permet d'isoler des variables concurrentes et d'éliminer le False Sharing (faux partage de cache), multipliant par 4 la vitesse d'exécution d'un traitement multi-cœurs.
Pré-requis recommandé : Si vous souhaitez revoir le fonctionnement matériel de la mémoire vive, le système d'adressage par octet et la hiérarchie des mémoires, consultez le guide dédié : Mémoire vive (RAM) : Fonctionnement & Architecture.
Le code source complet et les tests de performance présentés dans cet article sont disponibles sur le dépôt GitHub officiel : Chroq/memory-padding.
1. Comment fonctionne l'alignement mémoire en Go ?
Comme nous l'avons exploré dans l'article sur la Mémoire vive (RAM), le processeur manipule la mémoire par mots machine de 8 octets (64 bits). Pour garantir que chaque lecture s'effectue en un seul cycle d'horloge sans pénalité matérielle de recombinaison, le compilateur Go applique une règle stricte d'alignement.
La règle d'or de l'alignement
Pour éviter cette pénalité matérielle, le compilateur Go applique une règle universelle :
Règle fondamentale : Une variable de taille N doit obligatoirement débuter à une adresse mémoire divisible par sa taille (N octets).
- Un
int64,uint64ou pointeur (8 octets) → démarre à une adresse multiple de 8 (0, 8, 16, 24, 32...). - Un
int32oufloat32(4 octets) → démarre à une adresse multiple de 4 (0, 4, 8, 12, 16...). - Un
int16ouuint16(2 octets) → démarre à une adresse multiple de 2 (0, 2, 4, 6...). - Un
byteoubool(1 octet) → démarre à n'importe quelle adresse.
Exemple concret en Go : Observer le padding en direct
Voyons comment Go applique cette règle sur une structure simple :
 1package main
 2
 3import (
 4    "fmt"
 5    "unsafe"
 6)
 7
 8type Demo struct {
 9    a byte  // 1 octet
10    b int64 // 8 octets
11}
12
13func main() {
14    var d Demo
15
16    fmt.Printf("Adresse du champ 'a' : %p (offset %d)\n", &d.a, unsafe.Offsetof(d.a))
17    fmt.Printf("Adresse du champ 'b' : %p (offset %d - forcé au début du tiroir suivant !)\n",
18        &d.b, unsafe.Offsetof(d.b))
19}
Sortie console :
1Adresse du champ 'a' : 0xc0000a6000 (offset 0)
2Adresse du champ 'b' : 0xc0000a6008 (offset 8 - forcé au début du tiroir suivant !)
Pourquoi l'offset de b saute-t-il directement à 8 ?
Le champ a n'occupe que l'octet 0. L'octet 1 est libre, mais l'adresse 0xc0000a6001 n'est pas divisible par 8. Pour respecter l'alignement requis de b (int64), le compilateur Go est forcé de laisser un « trou » de 7 octets de padding invisibles et de placer b à l'offset 8 (0xc0000a6008), qui est le premier multiple de 8 disponible (le début du tiroir de 8 octets suivant).
Pourquoi les types composites (string, slice, struct, tableaux) s'alignent-ils ainsi ?
Il est fondamental de bien distinguer la taille en mémoire (unsafe.Sizeof) d'une donnée de son alignement requis (unsafe.Alignof) :
- Les Types Scalaires (Simples) : L'alignement requis est exactement égal à leur taille :
- Un
int32oufloat32de 4 octets s'aligne sur 4 octets. - Un
int64,uint64,float64ou pointeur*Tde 8 octets s'aligne sur 8 octets.
- Un
- Les Descripteurs (
string,slice,interface) :- Un
stringpèse 16 octets car il est constitué en interne d'une structure{ Data *byte, Len int }(2 champs de 8B). Son plus grand champ interne pesant 8 octets, son alignement requis est de 8 octets (et non 16). - Un
slice []Tpèse 24 octets car son en-tête contient{ Data unsafe.Pointer, Len int, Cap int }(3 champs de 8B). Quel que soit le typeTstocké dans le tableau sous-jacent (qu'il s'agisse d'un[]byte,[]float64, ou d'un[][1000]int), le descripteur de slice lui-même ne contient toujours que des pointeurs et entiers de 8 octets. Son alignement est donc toujours de 8 octets.
- Un
- Les Tableaux de taille fixe (
[N]T) :- La taille totale en mémoire est de N × taille(T), mais l'alignement requis est strictement égal à l'alignement de l'élément unitaire T :
[100]bytepèse 100 octets, mais son alignement requis n'est que de 1 octet ![4]int32pèse 16 octets, mais son alignement requis est de 4 octets.[10]float64pèse 80 octets, et son alignement requis est de 8 octets.
- La taille totale en mémoire est de N × taille(T), mais l'alignement requis est strictement égal à l'alignement de l'élément unitaire T :
- Les Structures Personnalisées (
struct) :- L'alignement d'une structure est toujours le maximum des alignements requis de ses champs :
struct { a byte; b int16 }→ max(1, 2) = alignement de 2 octets (taille = 4B).struct { a byte; b int32 }→ max(1, 4) = alignement de 4 octets (taille = 8B).struct { a byte; b float64 }→ max(1, 8) = alignement de 8 octets (taille = 16B).struct { arr [1000]byte }→ max(1) = alignement de 1 octet (taille = 1000B).
- L'alignement d'une structure est toujours le maximum des alignements requis de ses champs :
Existe-t-il un alignement supérieur à 8 octets en Go (sur architecture 64-bit) ?
Non. Sur les architectures 64-bit (x86-64 et ARM64), 8 octets (64 bits) représente la taille d'un mot machine scalaire maximal. Même des types larges comme complex128 (16 octets = deux float64) ou une structure géante de 10 000 octets ne dépassent jamais un alignement requis de 8 octets.
Tableau récapitulatif des types Go (Architecture 64-bit)
Ces valeurs sont vérifiables avec le package standard unsafe (unsafe.Sizeof et unsafe.Alignof) selon la spécification officielle Go :
| Type Go | Taille (unsafe.Sizeof) |
Alignement requis (unsafe.Alignof) |
Règle d'adresse mémoire |
|---|---|---|---|
bool, byte, int8, uint8 |
1 octet | 1 octet | N'importe quelle adresse |
int16, uint16 |
2 octets | 2 octets | Multiple de 2 |
int32, uint32, float32 |
4 octets | 4 octets | Multiple de 4 |
int64, uint64, float64, uintptr, pointeurs *T, chan |
8 octets | 8 octets | Multiple de 8 |
string (pointeur 8B + longueur 8B) |
16 octets | 8 octets | Multiple de 8 |
interface{} / any (type 8B + données 8B) |
16 octets | 8 octets | Multiple de 8 |
slice []T (pointeur 8B + len 8B + cap 8B) |
24 octets | 8 octets | Multiple de 8 |
2. Cas pratique : Anatomie d'une structure mal ordonnée
Considérons une structure représentant l'état d'un compte utilisateur :
1type BadStruct struct {
2    flagA bool  // 1 octet
3    count int64 // 8 octets
4    flagB bool  // 1 octet
5}
1type GoodStruct struct {
2    count int64 // 8 octets
3    flagA bool  // 1 octet
4    flagB bool  // 1 octet
5}
Visualisation mot à mot en mémoire (CPU 64-bit)
Observons comment le compilateur organise la mémoire pour BadStruct vs GoodStruct :
BadStruct (24 octets au total) :
Mot 1 [0..7B]  : [ flagA (1B) ][ PADDING GASPILLÉ (7B) ]
Mot 2 [8..15B] : [ count int64 (8B complets) ]
Mot 3 [16..23B]: [ flagB (1B) ][ PADDING GASPILLÉ (7B) ]
Bilan : 10 octets utiles + 14 octets de padding = 24 octets (58% de mémoire perdue)

GoodStruct (16 octets au total) :
Mot 1 [0..7B]  : [ count int64 (8B complets) ]
Mot 2 [8..15B] : [ flagA (1B) ][ flagB (1B) ][ PADDING TERMINAL (6B) ]
Bilan : 10 octets utiles + 6 octets de padding = 16 octets (-33% de mémoire)
Analyse de l'optimisation :
- Dans
BadStruct,count(8 octets) doit démarrer sur un multiple de 8, forçant le compilateur à insérer 7 octets de padding aprèsflagA. - Dans
GoodStruct, en réorganisant les champs par taille décroissante (8 octets → 1 octet → 1 octet),flagAetflagBse partagent leMot 2. - La structure passe de 24 octets à 16 octets, libérant immédiatement -33 % d'espace mémoire.
Pourquoi reste-t-il 6 octets de padding à la fin ?
La taille globale d'une structure est systématiquement arrondie au multiple supérieur de son plus grand alignement (8 octets). Si GoodStruct faisait 10 octets au lieu de 16, dans un tableau []GoodStruct, le deuxième élément items[1] débuterait à l'octet 10. Son champ count (8 octets) serait alors désaligné car 10 n'est pas divisible par 8. Le padding final garantit que chaque élément successif d'un tableau reste parfaitement aligné sur 8 octets.
Peut-on ordonner les champs par taille croissante ou dans un autre ordre ?
- L'ordre par taille décroissante (8B → 4B → 2B → 1B) est la méthode de référence : elle garantit mathématiquement 0 octet de padding interne, quelle que soit la combinaison de champs.
- L'ordre par taille croissante (1B → 2B → 4B → 8B) peut générer du padding interne si les petits champs ne totalisent pas exactement un multiple de l'alignement du champ suivant (ex: un
boolde 1B suivi d'unint64de 8B créera 7 octets de trou avant leint64). - Le principe clé : L'essentiel est de regrouper les petits types contigus (ex: deux
int32de 4B côte à côte, ou quatreint16de 2B) pour qu'ils comblent ensemble des mots machine complets de 8 octets sans laisser d'interstices.
3. Impact réel : RAM, Cache CPU L1/L2 et Garbage Collector
Ce gain de quelques octets par structure prend une dimension spectaculaire dès que vous manipulez des volumes importants de données en mémoire (caches, index de recherche, flux d'événements).
1. Économie de mémoire vive (RAM)
Sur une collection de 10 millions d'enregistrements stockés dans une slice en mémoire :
- Empreinte avec
BadStruct(24 octets) : 240 Mo de RAM - Empreinte avec
GoodStruct(16 octets) : 160 Mo de RAM - Gain net immédiat : 80 Mo de RAM économisés (soit 33 % de mémoire libérée)
2. Densité de cache CPU et taux de Cache Hits
Les processeurs ne travaillent pas directement dans la mémoire vive : ils rapatrient les données dans des caches ultra-rapides (L1, L2, L3). Le cache L1 de données fait généralement 32 Ko par cœur.
- Dans 32 Ko de cache L1, on peut loger 2 048 structures compactes de 16 octets (
GoodStruct). - On ne peut y loger que 1 365 structures mal agencées de 24 octets (
BadStruct).
En compactant vos structures, vous augmentez la densité utile du cache de +50 %. Lors d'un parcours de tableau (for range), le processeur trouve plus souvent la donnée directement en cache (Cache Hit). Il n'a pas besoin de suspendre son exécution pour attendre la RAM, ce qui maximise le nombre d'instructions exécutées par cycle d'horloge (IPC - Instructions Per Cycle).
3. Allègement du Garbage Collector
Des structures plus compactes réduisent le nombre total de pages mémoire allouées sur le tas (Heap), diminuant mécaniquement la charge et la fréquence des cycles de balayage du ramasse-miettes.
4. Détection et correction automatique avec fieldalignment
Il n'est pas nécessaire de calculer manuellement les décalages d'octets de chaque structure. L'écosystème Go fournit l'outil officiel fieldalignment issu de golang.org/x/tools.
1# Installation de l'outil officiel
2go install golang.org/x/tools/go/analysis/passes/fieldalignment/cmd/fieldalignment@latest
3
4# Analyse de votre projet
5fieldalignment ./...
6
7# Correction et réorganisation automatique de toutes vos structures
8fieldalignment -fix ./...
Exemple de rapport généré :
1internal/domain/user.go:12:11: struct with 24 bytes could be 16 bytes
Comment préserver l'ordre d'une structure spécifique ?
L'outil en ligne de commande fieldalignment -fix applique la réorganisation à toutes les structures détectées du projet. Cependant, dans plusieurs cas concrets, préserver l'ordre logique d'une structure prime sur le gain de quelques octets :
- DTOs et modèles d'API (JSON / gRPC) : Conserver les champs regroupés par cohérence métier (ex:
FirstName,LastName,Emailcôte à côte) améliore la lisibilité du code et la maintenance d'équipe. - Protocoles binaires et interfaçage CGO : Lorsque la disposition exacte des octets en mémoire doit respecter un format binaire réseau strict ou une structure C externe.
- Alignement atomique 64-bit : Sur architectures 32-bit où les variables 64-bit manipulées par
sync/atomicdoivent obligatoirement être placées au début de la structure.
Pour désactiver la réorganisation sur ces structures précises :
- Avec
golangci-lint(govet) : Placez la directive//nolint:govetau-dessus de la structure pour ignorer l'avertissement d'alignement. - Avec des linters dédiés (ex:
betteralignoufieldalign) : Utilisez le commentaire explicite// betteralign:ignoreou// fieldalign:ignore.
5. Quand le padding décuple les performances : Le False Sharing
Si le padding involontaire gaspille de l'espace, le padding explicite de 64 octets est un levier de performance majeur en programmation concurrente multi-cœurs.
Lignes de cache et protocole de cohérence
Les processeurs rapatrient la mémoire par blocs matériels de 64 octets appelés lignes de cache (Cache Lines).
Sur un processeur multi-cœurs :
- Chaque cœur possède son propre cache privé L1 et L2.
- Les cœurs partagent le cache L3.
- Pour garantir que tous les cœurs voient une mémoire cohérente, le matériel utilise un protocole de cohérence de cache, tel que le protocole MESI (Modified, Exclusive, Shared, Invalid).
Le phénomène du False Sharing (Faux partage)
Le False Sharing se produit lorsque deux goroutines s'exécutant sur deux cœurs différents modifient deux variables totalement indépendantes, mais situées sur la même ligne de cache physique de 64 octets.
La parade : Isoler chaque variable sur 64 octets
Pour éliminer cette contention matérielle, on force chaque variable concurrente à occuper une ligne de cache dédiée de 64 octets.
En Go, il existe deux manières d'implémenter ce padding d'isolation :
- Le padding explicite manuel : Ajouter un tableau anonyme de 56 octets (
_ [7]uint64: 8B de valeur + 56B de padding = 64B). - Le type système portable
cpu.CacheLinePad: Issu du package officielgolang.org/x/sys/cpu(et utilisé en interne dans le runtime Go etsync.Pool), ce type adapte automatiquement la taille du padding selon l'architecture processeur cible (64 octets sur x86-64/ARM64, 128 octets sur certaines architectures serveurs).
 1package padding
 2
 3import (
 4    "sync/atomic"
 5    "golang.org/x/sys/cpu"
 6)
 7
 8// ContendedCounter (8 octets) : plusieurs instances partagent la même ligne de 64B -> False Sharing
 9type ContendedCounter struct {
10    value atomic.Int64
11}
12
13// PaddedCounter (64 octets) : chaque instance isole sa propre ligne de cache
14type PaddedCounter struct {
15    value atomic.Int64
16    _     cpu.CacheLinePad // Padding matériel dynamique et portable (ou _ [7]uint64)
17}
Cas 1 : Sans Padding (False Sharing destructeur)
Ligne 64B : [ Counter 0 (8B) ][ Counter 1 (8B) ][ Counter 2 (8B) ][ Counter 3 (8B) ][ Inutilisé (32B) ]
Conflit : Cœur 0 écrit ⚡ CONFLIT MESI (Invalidations en boucle) ⚡ Cœur 1 écrit

Cas 2 : Avec Padding 64B (Lignes isolées)
Ligne Cœur 0 (64B) : [ Counter 0 (8B) ][ Padding isolation (56B) ] ──> Cœur 0 (Dédié)
Ligne Cœur 1 (64B) : [ Counter 1 (8B) ][ Padding isolation (56B) ] ──> Cœur 1 (Dédié)
Ligne Cœur 2 (64B) : [ Counter 2 (8B) ][ Padding isolation (56B) ] ──> Cœur 2 (Dédié)
Ligne Cœur 3 (64B) : [ Counter 3 (8B) ][ Padding isolation (56B) ] ──> Cœur 3 (Dédié)
- Sans padding : Dès que le Cœur 0 modifie
Counter 0, il invalide la copie de la ligne de cache du Cœur 1. Ce dernier doit recharger les 64 octets depuis le cache partagé L3, ralentissant drastiquement l'application (cache line bouncing). - Avec padding d'isolation (56 octets
cpu.CacheLinePad) : Chaque compteur occupe l'intégralité d'une ligne de cache de 64 octets. Chaque cœur travaille en toute indépendance sans aucune interférence matérielle.
6. Benchmark et Mesures Réelles
Comparons l'exécution de 4 goroutines incrémentant chacune 10 000 fois leur propre compteur atomique :
 1package padding
 2
 3import (
 4    "sync"
 5    "testing"
 6)
 7
 8func BenchmarkFalseSharing(b *testing.B) {
 9    var counters [4]ContendedCounter
10    var wg sync.WaitGroup
11
12    for b.Loop() {
13        wg.Add(4)
14        for c := range 4 {
15            go func(idx int) {
16                for range 10_000 {
17                    counters[idx].value.Add(1)
18                }
19                wg.Done()
20            }(c)
21        }
22        wg.Wait()
23    }
24}
25
26func BenchmarkPaddedNoSharing(b *testing.B) {
27    var counters [4]PaddedCounter
28    var wg sync.WaitGroup
29
30    for b.Loop() {
31        wg.Add(4)
32        for c := range 4 {
33            go func(idx int) {
34                for range 10_000 {
35                    counters[idx].value.Add(1)
36                }
37                wg.Done()
38            }(c)
39        }
40        wg.Wait()
41    }
42}
Résultats de la mesure
Mesures exécutées sur processeur Intel Core i7-8665U (4 cœurs physiques / 8 threads) à partir du dépôt Chroq/memory-padding :
1go test -bench=. -benchmem -count=5 ./...
| Implémentation | Temps moyen / Opération | Mémoire / Opération | Allocations / Opération | Vitesse relative |
|---|---|---|---|---|
| Sans padding (False Sharing) | 1 239 751 ns/op (1,24 ms) | 192 B/op | 8 allocs/op | Référence (1.0x) |
| Avec padding 64B (Ligne isolée) | 297 576 ns/op (0,30 ms) | 192 B/op | 8 allocs/op | 4,2x plus rapide |
Analyse de l'impact mémoire et performance
- Moyennes et conditions de mesure : Les chiffres présentés sont des moyennes calculées sur 5 séries d'exécutions consécutives (
-count=5) sur un processeur Intel Core i7 (4 cœurs / 8 threads). - Gain théorique et variabilité : Il s'agit d'un benchmark synthétique en boucle fermée illustrant un cas de contention matérielle maximale. En production réelle, les résultats peuvent varier selon la topologie processeur (AMD EPYC, Apple Silicon, architectures NUMA), le nombre de cœurs et la fréquence réelle des écritures concurrentes.
- Vitesse multipliée par 4,2 : Le simple ajout du padding d'isolation divise le temps d'exécution par plus de 4.
- Impact sur l'empreinte mémoire :
ContendedCountern'occupe que 8 octets en RAM.PaddedCounteroccupe 64 octets (8 octets de valeur + 56 octets de padding).- On consomme 8 fois plus de mémoire par compteur. C'est un compromis d'ingénierie (trade-off) parfaitement assumé : consommer 56 octets de RAM supplémentaires sur quelques compteurs pour quadrupler la bande passante globale de votre application concurrente.
- Zéro allocation supplémentaire : Les 192 B/op et 8 allocations mesurés correspondent uniquement au démarrage des 4 goroutines et de la synchronisation
sync.WaitGroup. Le gain provient à 100 % de l'élimination des conflits de cache au niveau matériel.
7. Synthèse : Les Deux Visages du Padding en Go
| Dimension | 1. Padding Involontaire (Gaspillage) | 2. Padding Intentionnel (Accélération) |
|---|---|---|
| Contexte cible | Stockage séquentiel (Slices volumineuses, Caches, Modèles SQL) | Concurrence multi-cœurs (Compteurs atomiques, Ring Buffers) |
| Problème matériel | Champs mal ordonnés créant des trous de mémoire inutiles | Variables indépendantes partageant une même ligne de 64 octets (False Sharing) |
| Conséquence | Surconsommation de RAM et perte de place en cache L1/L2 (-33%) | Invalidations permanentes de cache entre cœurs processeur (chute de vitesse) |
| Action à mener | Compacter : Ordonner les champs du plus large au plus petit (8B -> 4B -> 2B -> 1B) |
Isoler : Ajouter un cpu.CacheLinePad (ou _ [7]uint64) pour atteindre 64 octets |
| Outillage / Règle | Automatiser via fieldalignment -fix ./... |
Isoler uniquement les variables partagées modifiées à haute fréquence |
Ressources & Références Externes
- Dépôt GitHub du Benchmark Memory Padding : Code source complet et protocole de test.
- Spécification Officielle Go : Size and Alignment Guarantees : Spécification formelle des tailles et alignements.
- Package standard Go sys/cpu (CacheLinePad) : Documentation du padding de ligne de cache dynamique.
- Code source officiel de sync.Pool : Exemple concret d'utilisation de
CacheLinePaddans la bibliothèque standard Go. - Intel® 64 and IA-32 Architectures Optimization Reference Manual : Manuel officiel d'optimisation d'architecture Intel (Chapitre 3.7.3 False Sharing).
- Protocole de Cohérence de Cache MESI : Référence sur la synchronisation matérielle inter-cœurs.